資料庫主鍵怎麼選|Auto-Increment、UUIDv7、ULID、Snowflake 對照
用一張表把四種常見 ID 方案講完:單庫自增、時間排序的 UUIDv7 與 ULID、以及 64-bit 的 Snowflake。先選型,UUID 版本史與 Snowflake 運維另開深挖。
- UUID
- UUIDv7
- ULID
- Snowflake
- 資料庫主鍵
- 分散式系統
多數資料表一開始都用自增整數當主鍵:MySQL 的 AUTO_INCREMENT、SQL Server 的 IDENTITY、PostgreSQL 的 BIGSERIAL。數字短、索引順、JOIN 也省空間。系統還停在單一資料庫、ID 也不對外暴露時,這樣就夠用。
這篇只做一件事:對照四種主鍵策略,幫你選定。
一旦要在多台機器各自發號、要把幾個庫的資料合併、或不想讓 /orders/1001 這種網址洩漏每天單量,自增就會開始綁手綁腳。這時常見的下一站是 UUIDv7、ULID 或 Snowflake——三者都能時間排序、分散式生成,但長度、標準地位、運維成本差很多。
先看對照表
| 特性 | 傳統 Auto-Increment | UUIDv7 | ULID | Snowflake |
|---|---|---|---|---|
| 生成來源 | 資料庫單點生成 | 分散式客戶端/服務端 | 分散式客戶端/服務端 | 分散式專屬服務節點 |
| 型態與長度 | Integer/BigInt(4–8 bytes) | Binary 16 bytes,或字串 36 字元 | Binary 16 bytes,或字串 26 字元 | BigInt(8 bytes/64-bit) |
| 時間戳排序 | 否,僅依寫入順序 | 是,毫秒級 | 是,毫秒級 | 是,毫秒級 |
| 分散式唯一 | 差,需依賴中央資料庫 | 極高 | 極高 | 高,需配置 Worker ID |
| 索引友善度 | 極高,叢集索引最愛 | 高,時間遞增、減少頁分裂 | 高,時間遞增、減少頁分裂 | 極高,長度短且時間遞增 |
| 可讀性 | 最好(1, 2, 3…) | 普通(36 字元含連字號) | 26 字元 Crockford Base32 | 普通(18–19 位數字) |
時間排序的三種,寫入行為都接近自增:新鍵值通常比舊的大,B-tree 插入點集中在尾端,比較不會像純隨機的 UUIDv4 那樣把索引頁拆得到處都是。真正要選的,是 要不要 8 bytes、要不要標準 UUID 生態、要不要自己管節點編號。
四種方案怎麼取捨
傳統 Auto-Increment
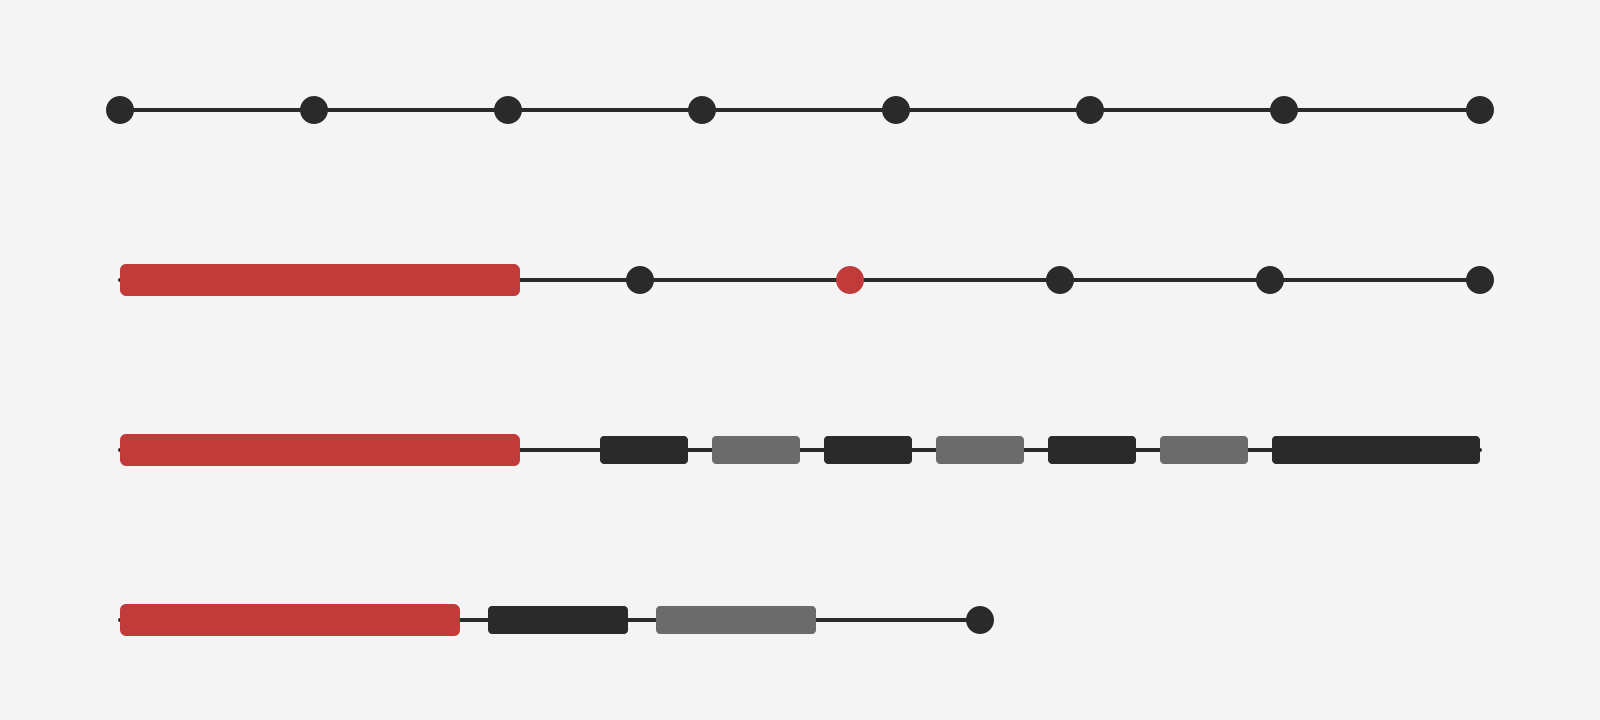
原理:資料庫內部計數器在寫入時自動加 1。應用程式通常不自己發號,把主鍵交給 IDENTITY/AUTO_INCREMENT/SERIAL。BIGINT 常見切法如下。
優點:佔用 4–8 bytes,叢集索引幾乎是理想狀態;ID 連續,除錯、對帳、人工查單都直覺。
缺點:發號綁在單一資料庫上,多寫入節點會衝突或變成效能瓶頸。對外暴露時,從訂單 ID 就能推每天單量。
適用:單一資料庫、資料量中小型、主鍵不對外、也沒有多庫合併需求。
Snowflake
原理:Twitter 提出的 64-bit 長整數。常見切法如下。
同一毫秒內每個節點最多約 4096 個 ID,整體大致按時間遞增。
優點:趨勢遞增、欄位就是 BIGINT,索引與 JOIN 都比 128-bit 省空間。
缺點:依賴系統時鐘,回撥可能重複發號。每台機器要有唯一 Worker ID。JavaScript 的 Number 只能安全表示 53-bit,前端或 Node 必須用字串或 BigInt。
適用:大型分散式、微服務,且資料庫明確希望主鍵維持 BIGINT。節點邊界清楚、已有協調機制時最划算。
ULID
原理:48-bit 毫秒時間戳加上 80-bit 隨機數,共 128-bit。預設編成 26 個字元的 Crockford Base32,沒有連字號、URL 安全、大小寫不敏感,字串本身就能按字典序排序。
01ARZ3NDEKTSV4RRFFQ69G5FAV
優點:分散式各自生成、不需 Worker ID;人眼讀寫比帶連字號的 UUID 輕鬆;二進位同樣 16 bytes,必要時也能塞進 uuid/BINARY(16)。
缺點:不是 IETF RFC,多半要靠第三方套件。128-bit 在「主鍵一定要整數」的庫裡仍輸給 Snowflake。同一毫秒內若沒用單調遞增實作,順序不一定嚴格。
適用:高併發、要全域唯一,且 ID 常出現在 URL、log、前後端傳輸。
UUIDv7
原理:RFC 9562 定義的時間排序 UUID。前 48-bit 放 Unix 毫秒時間戳,其餘大致為隨機。外觀仍是熟悉的 8-4-4-4-12。
018f3c2b-7c5a-7b91-9c8e-2f1c4d3a9b12
優點:分散式免協調;時間遞增對 B-tree 友善;PostgreSQL 18 已有 uuidv7()。從舊的 v4 主鍵遷移時,仍留在 UUID 型別裡,工具鏈阻力最小。
缺點:本質仍是 128-bit,儲存與索引大約是 Snowflake 的兩倍。內建的 UUID.randomUUID()、crypto.randomUUID() 產生的都是 v4,不要誤當成 v7。
適用:現代分散式架構的預設首選——想取代 UUIDv4,又不想引入 Snowflake 的節點管理。
UUIDv7 要解決的是 UUIDv4 當叢集主鍵 的問題:v4 純隨機,新列會插入索引中間任意位置,頁分裂、快取失效、寫入放大在 InnoDB 這類「資料跟主鍵叢集存放」的引擎上特別明顯。v7 把時間放最前面,寫入重新接近追加。v1 洩漏 MAC、v6 只是 v1 重排、v8 留給自訂,這些版本差異留給後續 UUID 深挖文。Worker ID 怎麼分配、各家 Snowflake 變體怎麼切位元,同樣留給後續深挖。
UUIDv7 與 ULID:同一個想法,兩套包裝
兩者都是 128-bit、時間在前、可排序、用來避開 v4 的索引碎片。差異幾乎只在標準與表示法。
選 UUIDv7
要官方標準、資料庫/語言原生支援,或必須繼續用 UUID 欄位。
選 ULID
要較短、人眼友善的字串,或專案已有成熟的 ULID 工具鏈。
新專案沒有特別理由時,從 v7 起步通常比較省事。
怎麼選:一條決策路徑
單庫 · 不對外
沒有多機發號 → 繼續用 Auto-Increment。空間與 JOIN 都划算。
必須 BIGINT
要分散式,且主鍵必須是整數 → Snowflake。先確認 Worker ID 與時鐘誰來顧。
UUID 生態
要分散式,想跟 UUID 欄位、現有函式庫相容 → UUIDv7。
字串友善
要分散式,ID 常當字串出現在 URL/log → ULID。
不是叢集主鍵
這個欄位只要隨機、不在乎排序 → v4 或 NanoID 仍可用,不必硬上時間排序 ID。
內部主鍵與對外 ID 分開
內部可用自增或 Snowflake 顧索引;對外用 v4 或另一層編號,避免把建立時間或業務規模寫進公開網址。
三個常見坑
不要把 UUIDv4 當叢集主鍵。隨機插入會造成頁分裂與寫入放大。要留在 UUID 型別裡,換成 v7。
時間排序 ID 會洩漏建立時間。v7、ULID、Snowflake 都能反推「大約何時建立」。帳號 ID 若會暴露註冊先後,就不要直接當對外識別碼。Snowflake 另外還可能讓人推敲節點規模。
JavaScript 裝不下 64-bit Snowflake。Number.MAX_SAFE_INTEGER 只有 53-bit。前端或 Node 請用字串或 BigInt,並確認 ORM 不會把它轉成 Number。
小結
比較上,單庫、ID 不對外,自增整數仍然合理;要分散式又在意索引,時間排序的 UUIDv7、ULID、Snowflake 才進場。沒有分散式或對外暴露的壓力,原本的整數主鍵其實就很好。真的要換,先問欄位型別能不能接受 16 bytes、願不願意維護 Worker ID。
筆者團隊實踐模式:現場以 ULID 為主鍵
前文是比較文,四種方案各有主場。這一節改以筆者口吻,說明我參與的產品線實際怎麼走——以這篇文章撰寫時為準。
多數團隊仍是自增整數
我待過的團隊裡,絕大多數主鍵仍是自增整數。原因很務實,不是誰沒跟上潮流:系統多半從早期單體長出來,資料庫單點發號就夠用;教材與面試範本教的,也幾乎都是 IDENTITY/AUTO_INCREMENT/SERIAL。沒有多機寫入、也不把 ID 當對外指紋時,這套沒必要為了新名詞拆掉。
時間排序 ID 會被拿出來吵,是近幾年分散式架構變普遍之後的事:多個環境、多個服務各自寫入,每筆資料還是得有一枚撞不到的指紋。國際社群才把 UUIDv7、ULID、Snowflake 從「有人在用」變成選型題。
辯論從哪裡來
我曾在區塊鏈公司工作時,為主鍵吵過很兇。習慣傳統自增主鍵的工程師會把「非int整數」、「分散式發號」看成「非正規」——即「不連續、不像教科書教的、資料庫「看起來不乾淨」」。主要是因為很多工程師單體時代的直覺還在:認為主鍵就該是資料庫給的傳統自增式流水號主鍵。
後來分散式變成日常,這場辯論的力道才慢慢掉下來。現場要回答的不再是「哪一種比較正統」,而是「發號能不能離開單一資料庫」。
我們走哪一條
輪到我自己帶的團隊,主鍵選的是 ULID。UUIDv7 進 RFC 之前,要時間排序、又能在各端各自生成、還不想養 Snowflake 的 Worker ID,手上能穩定用的就是 ULID,於是就定下來了。
- 不是自增: 發號不能再綁單一資料庫。
- 不是 Snowflake: 當時沒有要維護節點編號的基礎設施,也不想為了 8 bytes 先上協調層。
- 也還不是 UUIDv7: 標準與語言原生支援還沒到位時就得上線;ULID 工具鏈已經能跑。v7 普及之後要不要遷,是下一題,不是當時的必考題。